

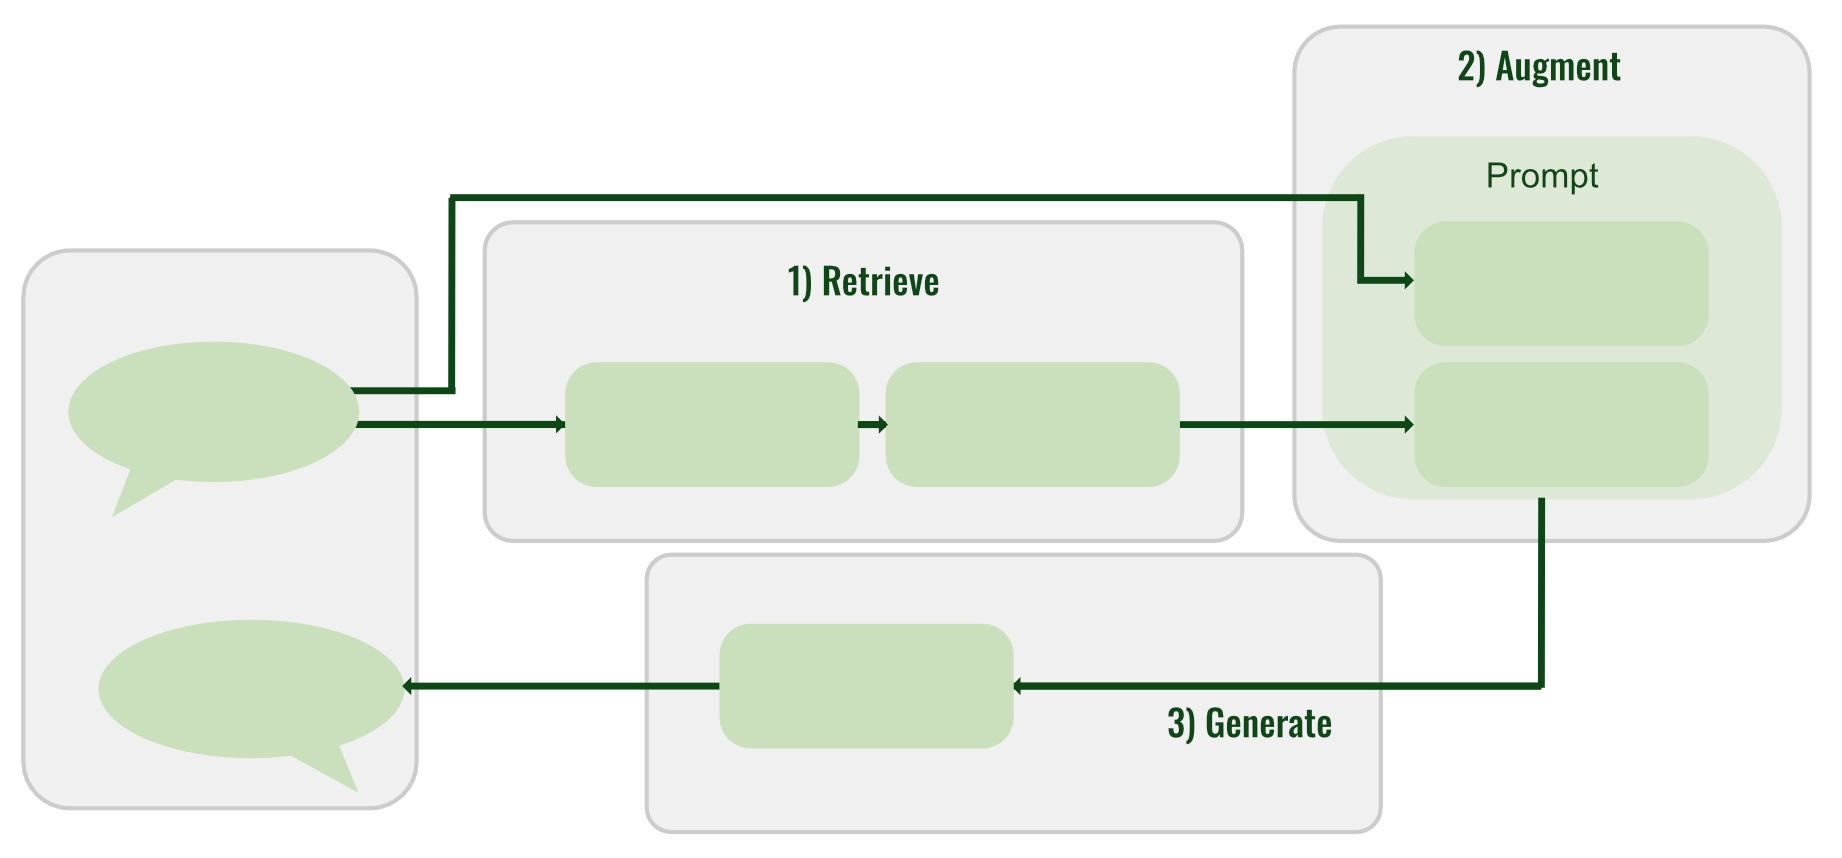
Schritte bei RAG-Anfrage
Ziehen Sie die Schlagworte an die richtige Stelle.
Embedding
Embedding: Vektorisierung der Suchanfrage.
Die Textanfrage wird an dasselbe Embedding-Modell gesendet, das auch bei der vorherigen Indexierung der Dokumente verwendet wurde. Das Modell wandelt die Frage in einen hochdimensionalen Zahlenvektor um.
Die Textanfrage wird an dasselbe Embedding-Modell gesendet, das auch bei der vorherigen Indexierung der Dokumente verwendet wurde. Das Modell wandelt die Frage in einen hochdimensionalen Zahlenvektor um.
Eingabe
Eingabe: Eingabeerfassung und Aufbereitung. Die Suchanfrage wird vom Nutzer eingegeben. Vor der Weiterverarbeitung wird die Anfrage bereinigt (z. B. Entfernen von Sonderzeichen).
Rahmen-
bedingungen
bedingungen
Rahmenbedingungen: Eingabeerfassung und Aufbereitung. Die Suchanfrage wird vom Nutzer eingegeben. Vor der Weiterverarbeitung wird die Anfrage bereinigt (z. B. Entfernen von Sonderzeichen).
Ausgabe
Generate: Antworterstellung. Das Large Language Model (LLM) erhält den angereicherten Prompt und generiert eine präzise, auf dem bereitgestellten Kontext basierende Antwort.
Inhaltliche Antwort
Prompt Augmentation: Kontext-Anreicherung.
Die ausgewählten Textpassagen werden zusammen mit der ursprünglichen Frage und Systeminstruktionen zu einem erweiterten Prompt zusammengefügt (z. B. "Beantworte die Frage ausschließlich auf Basis folgender Informationen: [Kontext...]").
Die ausgewählten Textpassagen werden zusammen mit der ursprünglichen Frage und Systeminstruktionen zu einem erweiterten Prompt zusammengefügt (z. B. "Beantworte die Frage ausschließlich auf Basis folgender Informationen: [Kontext...]").
Vektordaten-
basis
basis
Retrieve (Ähnlichkeitssuche): Abfrage der Vektordatenbank.
Der erzeugte Vektor wird mit den Vektoren in der Vektordatenbank verglichen. Mithilfe von Ähnlichkeitsmaßen (wie der Kosinus-Ähnlichkeit oder dem Euklidischen Abstand) werden die Top-K passendsten Textausschnitte (Chunks) identifiziert. Chunks mit zu geringer Relevanz werden verworfen, um das Sprachmodell nicht mit irrelevantem Kontext zu überfordern.
Der erzeugte Vektor wird mit den Vektoren in der Vektordatenbank verglichen. Mithilfe von Ähnlichkeitsmaßen (wie der Kosinus-Ähnlichkeit oder dem Euklidischen Abstand) werden die Top-K passendsten Textausschnitte (Chunks) identifiziert. Chunks mit zu geringer Relevanz werden verworfen, um das Sprachmodell nicht mit irrelevantem Kontext zu überfordern.
LLM
Generate: Antworterstellung.
Das Large Language Model (LLM) erhält den angereicherten Prompt und generiert eine präzise, auf dem bereitgestellten Kontext basierende Antwort.
Das Large Language Model (LLM) erhält den angereicherten Prompt und generiert eine präzise, auf dem bereitgestellten Kontext basierende Antwort.
Ziehe die Schlagworte an die richtige Stelle!

